从Nature|Science文章看全球尺度研究中的外推风险
几天前,我曾写过一篇关于 Bastin 等(2019,Science) 《 The global tree restoration potential 》质疑风波的推文。提出了一个问题:当一个全球尺度的地图看起来完整、精确,甚至具备直接的政策吸引力时,它的证据基础是否真的足以…
- Reference
- notes:n20
- Published
- 2026.03.29
- Series
- note
- Source
- Source ↗
几天前,我曾写过一篇关于 Bastin 等(2019,Science) 《 The global tree restoration potential 》质疑风波的推文。提出了一个问题:当一个全球尺度的地图看起来完整、精确,甚至具备直接的政策吸引力时,它的证据基础是否真的足以支撑这种“全球性”?为此,我提出了一个简单但必要的判断框架:任何一个 global map,至少需要同时经受三重审查——输入数据是否可靠,模型验证是否严谨,外推边界是否明确。
如果把视野从一篇 highly influential 的 Science 论文,扩展到几篇近年 Nature/Science 正刊文章,会发现这并不是个例,而是一种更普遍的方法学问题。近年的顶刊研究,越来越擅长把局地观测转化为全球叙事:把数万土壤样点转化为全球多样性热点图,把有限区域的训练数据扩展为全球生态系统分布图,把近二十年可以验证的 proxy 延伸为跨越半个世纪的环境变化记录。
从方法学上看,这类研究往往面临两种关键的 representation mismatch(表征错配)。第一类是 空间代表性错配(spatial representativeness mismatch) :训练数据只覆盖了全球环境空间的一部分,但模型输出却是连续的全球表面。第二类是 时间表征错配(temporal representativeness mismatch) :要么将近年建立的 proxy 或经验关系延伸用于解释更早几十年的过程,要么将长度有限、起点不一的时间序列汇总为“全球长期变化格局”。对应地,前者主要表现为 空间外推脆弱性(spatial extrapolation fragility) ,后者则更容易导致 时间解释过度(temporal over-interpretation) 。
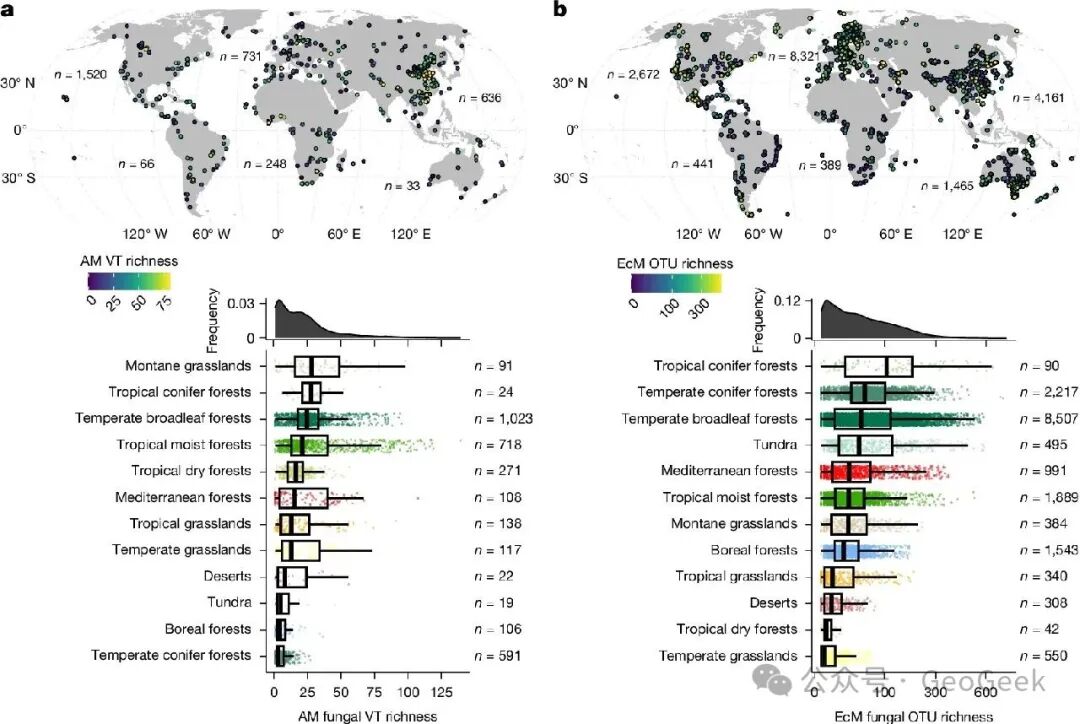
图1|样点分布先于全球预测。Van Nuland 等(2025,Nature)在主文 Fig. 1 中展示了菌根真菌全球分析所依据的样点位置与不同生物群系中的 richness 变化趋势。对全球尺度结论而言,首先需要追问的不是“地图是否精细”,而是“这些样点是否足以代表全球环境空间”。
一、 空间外推风险
一个典型例子,是 Van Nuland 等(2025,Nature) 的 Global hotspots of mycorrhizal fungal richness are poorly protected 。这篇论文使用约 25,000 个地理定位土壤样本训练机器学习模型,生成全球 1 km² 分辨率的菌根真菌 richness 与 rarity 热点图。 问题不在于样本数量不够大,而在于样本的空间分布并不均衡 。作者在正文与扩展数据中都明确提示,现有采样更集中于 North America、Europe 和 Asia;主图还直接用交叉阴影标出“underrepresented by the training data (highly extrapolated)”的区域,并说明这些区域应谨慎解释。更重要的是,模型在随机交叉验证与更严格的空间交叉验证之间存在明显落差:richness 模型中,AM 的 R² 从 0.61 降到 0.20,EcM 从 0.63 降到 0.28;rarity 模型中,AM 的 kNNDM R² 甚至为 -2.55。换句话说,这篇论文最值得读者重视的信息,不只是“全球热点在哪里”,而是作者自己已经说明: 相当一部分全球热点,是在明显外推条件下得到的 。
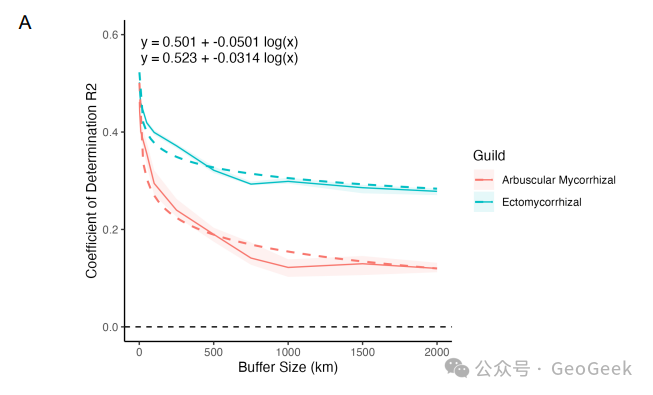
图2|空间独立验证下,模型表现明显下降。Van Nuland 等(2025,Nature)补充材料 Supplementary Fig. 3 显示,在 spatially buffered leave-one-out cross-validation 中,随着 buffer size 增大,模型的 R² 持续下降。
这里最容易被忽略的一点是,随机交叉验证给出的高精度,并不自动等于对陌生区域的可靠预测。几天前那篇关于 Bastin 论文的推文中,我已经借助 Ploton 等(2020,Nature Communications) 的分析讨论过这个问题: 如果训练集与测试集在空间上并不独立,模型性能就可能被系统性高估 。Van Nuland 等这篇论文其实已经把这一点部分写进了自己的方法体系:他们没有只给随机验证,而是同时给了空间验证。正因为如此,这篇论文反而是一个很好的教学案例——它并不是“做错了”,而是清楚地展示了:当研究对象是全球连续表面时,模型的空间可迁移性往往远弱于随机验证所暗示的程度。
类似的问题,在 Rohde 等(2024,Nature) 的 Groundwater-dependent ecosystem map exposes global dryland protection needs 中表现得更直接。论文利用 34,454 个 training points、结合 2015–2020 年 Landsat 8 与其他环境变量,绘制了全球 drylands 的约 30 m GDE 分布图。作者在正文中明确写道,他们的目标之一就是提供一个“ conservative (low) estimate ”,并把它视为后续 regional refinement 与 ground validation 的起点,而不是终点。之所以这样表述,是因为作者同样意识到模型需要在“ regions lacking training data ”的地方工作;相应地,他们做了区域留出验证,结果 Sahel、Western Australia 和 New Mexico 的验证精度分别只有 69%、53% 和 61%。论文还明确承认,研究受限于“ lack of a globally consistent ground-truth dataset ”,并依赖 regional expert opinion 来区分 GDE 与 non-GDE vegetation。也就是说,这篇论文面对的不只是训练点分布不均,更是 标签定义并非全球同质 的问题。
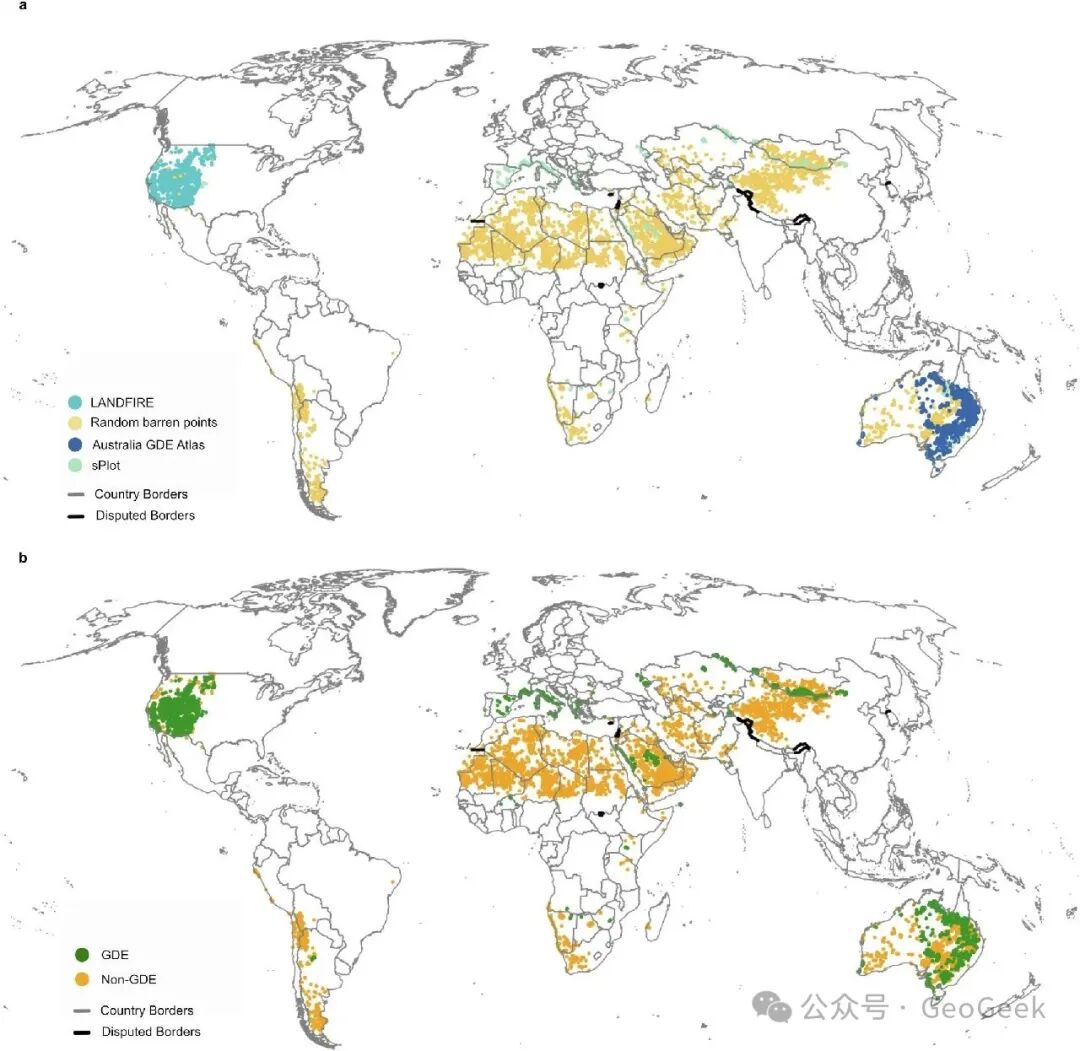
图3|训练集空间分布。Rohde 等(2024,Nature)在 Extended Data Fig. 1 中列出了 GDE 模型训练与验证数据的来源及分类分布。对这类全球生态制图而言,训练点覆盖范围与标签口径的一致性,往往比最终地图本身更值得审查。
这也是为什么,“全球地图”在方法上最容易制造一种误解:它会在视觉上给人一种均质、连续、完整的印象,但实际上的证据强度往往高度不均匀。 Meyer 与 Pebesma(2022,Nature Communications) 对此提出的 area of applicability 框架,非常适合拿来理解 Van Nuland 等与 Rohde 等这两篇 Nature 论文。问题并不是这些工作不该做全球图,而是它们的结果更适合被理解为 hypothesis map 或 screening layer :在训练数据支撑充分的区域,它更接近可操作的信息产品;在高度外推或标签口径不一致的区域,它更像一张需要后续验证的优先排查地图。你前几天那篇关于 Bastin 论文的推文,其实已经非常清楚地指出了这一点:global map 的价值,不应自动被理解为 globally uniform reliability。
二、 时间外推风险
时间维度上的问题,在 Miles 与 Bingham(2024,Nature) 的 Progressive unanchoring of Antarctic ice shelves since 1973 中表现得最典型。这篇论文的重要贡献,是试图把 Antarctic ice-shelf thickness change 的证据链从卫星测高时代之前继续向前延伸。作者在摘要与正文中写得非常明确:现有 altimetry 对冰架厚度变化的直接观测大致始于 1992 年,而他们的方法,是用 pinning-point area change 作为 thickness change 的 proxy,将记录延伸回 1973–1989。论文的核心表述是:他们测量了 1973–1989、1989–2000 和 2000–2022 三个时期的 pinning-point change,并“ by proxy infer changes to ice-shelf thickness back to 1973–1989 ”。这个方法并不粗糙,恰恰相反,它相当有创见;但它同时也构成了一个很典型的 temporal transfer 场景: 近年可交叉验证的 proxy,被延伸用来解释更早几十年的过程。
因此,这篇论文最需要谨慎阅读的,不是它“向前追溯了 50 年”这个表述本身,而是:这种 50 年尺度究竟意味着什么。它并不等同于“拥有 50 年同质、连续、直接的厚度观测”;更准确地说,它意味着: 作者把近期得到部分验证的 proxy 关系,结合历史 Landsat mosaics,构建成了一个五十年尺度的重建叙事。 论文自己也交代了这种重建的条件:早期影像需要重新拼接,1970s 与 1980s 的 mosaics 实际上由跨若干年的影像组成;早期 Landsat 影像在 Antarctic 的 geolocation accuracy 较差,需要手工 co-registration;同时,altimetry 本身主要覆盖更近的时期。正因为如此,这篇论文最稳妥的理解应当是 proxy-supported reconstruction ,而不是与近几十年的卫星测高观测处于同一证据等级的长时序实测。
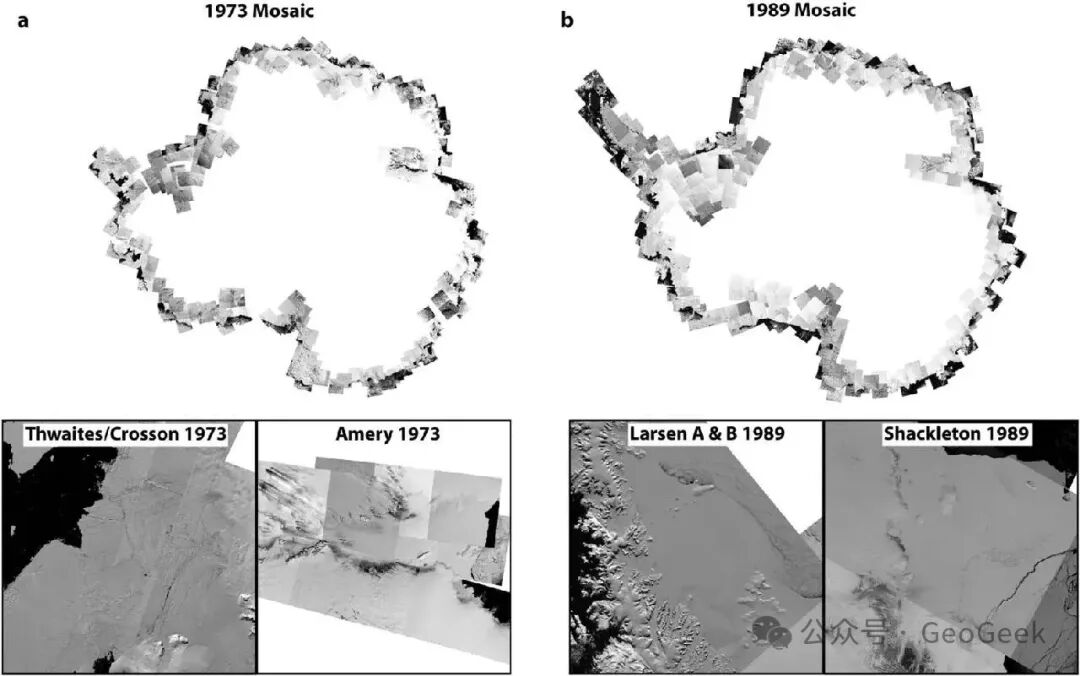
图5|时间节点背后,其实是跨年份拼接的影像产品。Miles 与 Bingham(2024,Nature)在 Extended Data Fig. 1 中展示了 1973 与 1989 两期南极冰架 mosaics;而正文说明,这两个“年份”都由跨若干年的 Landsat 影像拼接而成。
相比之下, Blowes 等(2019,Science) 的 The geography of biodiversity change in marine and terrestrial assemblages 属于另一类时间问题。它不是严格意义上的 temporal transfer,因为作者并没有用近年的样点去直接回推几十年前某个连续过程;它的问题更接近 temporal representativeness mismatch 。论文基于 BioTIME 等数据源,整合了 239 个独立研究,并通过 gridding 与 filtering 得到 51,932 条 local assemblage time series,用来刻画全球 biodiversity change 的空间结构。作者自己在正文中明确承认,这些时间序列从 19 世纪末延续到当代,但 大部分数据来自过去 40 年 ,而且 temporal extent and start date vary substantially 。同时,论文也明确承认,BioTIME 在热带地区的数据仍然相对有限。也就是说,这篇论文要解释的是“全球 biodiversity change 的地理格局”,但底层时间证据并不是一组长度相近、起点一致的长期观测,而是 大量时长有限、起点不一、年代结构不均匀的局部序列。
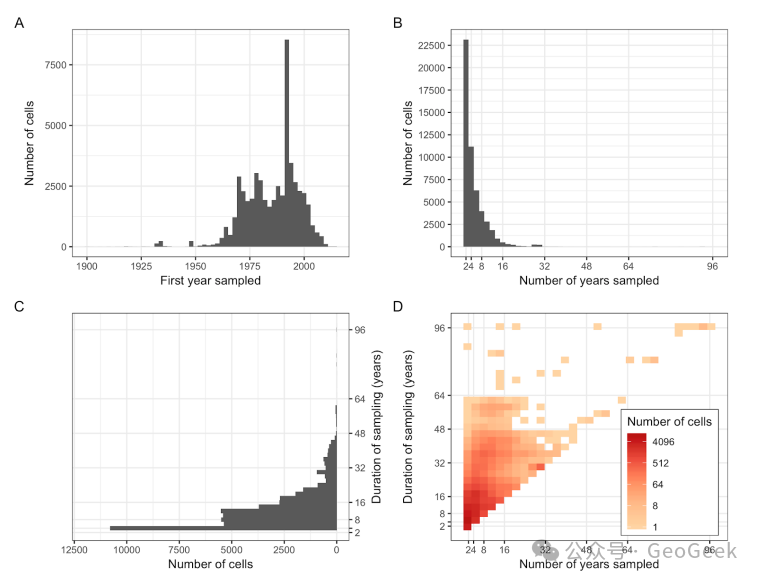
图5|全球变化格局建立在时间代表性不均一的序列之上。Blowes 等(2019,Science)在补充材料 Fig. S2 中展示了纳入分析的时间序列在起始时间与持续时间上的分布。可以看到,大多数序列集中在近几十年,且持续时间有限。这意味着所谓“全球生物多样性变化格局”,在一定程度上是由时间跨度较短、起点不一致的局地序列拼接而成。
这类研究的风险不在于“结果一定不成立”,而在于它很容易被过度理解为对“长期全球变化格局”的稳定刻画。实际上,这类分析在很大程度上更接近于: 在目前可用、且年代结构并不均匀的时间序列集合中,识别出哪些区域更频繁地表现出显著的 richness change 或 turnover。 这与“哪里在更长历史尺度上持续变化得最强”并不是完全相同的问题。换句话说,Miles 与 Bingham 那篇论文的问题,是把近年可校验的关系向更早时期迁移;Blowes 等这篇论文的问题,则是把 长度与起点都高度异质的时间证据 ,汇总成全球尺度的空间比较。两者并不相同,但都属于时间维度上的 representation mismatch。
三、证据边界的理解
如果把这四篇论文放在一起看,会发现一个相当清楚的共同点:今天最有影响力的 global-change research,越来越依赖大范围汇总数据、遥感、机器学习和 proxy reconstruction。这样的研究非常必要,也常常是最有价值的;但它们最容易被传播、也最容易被误读的部分,往往正是那些最依赖外推的部分。一个连续的全球图,很容易让人误以为每个像元都同样可信;一个跨 50 年的历史叙事,很容易让人误以为 50 年里的证据质量是均一的。真正需要修正的,不是这些研究提出 global-scale questions 的雄心,而是我们对它们 证据边界 的默认理解。
因此,比“这篇论文对不对”更重要的问题,常常是: 它的结论在哪些区域、哪些时期、哪些解释层次上更可靠? 对全球地图,要问训练样点是否足以覆盖目标环境空间,验证是否采用了空间独立的方案,外推区域是否被明确标出;对长时段叙事,要问它究竟是直接观测、proxy-supported reconstruction,还是对异质时间序列的综合比较。也正是在这个意义上,这四篇 Nature/Science 论文提供的最重要启示,不是某一个结论是否可以简单接受或否定,而是: 当结论尺度大于证据尺度时,representation mismatch 就会成为决定论文应当如何被阅读的关键。
References
Bastin, J.-F., Finegold, Y., Garcia, C., Mollicone, D., Rezende, M., Routh, D., Zohner, C. M., & Crowther, T. W. (2019).The global tree restoration potential. Science, 365 (6448), 76–79.
Ploton, P., Mortier, F., Réjou-Méchain, M., Barbier, N., Picard, N., Rossi, V., Redmond, I., Veillon, L., Bayol, N., Williamson, J., et al. (2020).Spatial validation reveals poor predictive performance of large-scale ecological mapping models. Nature Communications, 11 , 4540.
Meyer, H., & Pebesma, E. (2022).Machine learning-based global maps of ecological variables and the challenge of assessing them. Nature Communications, 13 , 2012.
Van Nuland, M. E., Averill, C., van den Hoogen, J., et al. (2025).Global hotspots of mycorrhizal fungal richness are poorly protected. Nature .
Rohde, M. M., Albano, C. M., Stella, J. C., et al. (2024).Groundwater-dependent ecosystem map exposes global dryland protection needs. Nature, 632 , 101–107.
Miles, B. W. J., & Bingham, R. G. (2024).Progressive unanchoring of Antarctic ice shelves since 1973. Nature, 626 , 785–791.
Blowes, S. A., Supp, S. R., Antão, L. H., et al. (2019).The geography of biodiversity change in marine and terrestrial assemblages. Science, 366 (6463), 339–345.