Nature Communications:论文如何写好因果?
温度升高影响物种死亡率; 洪水改变河口双壳类丰度; 捕食者数量下降导致猎物种群增加; 人类活动改变动物栖息地利用。
- Reference
- notes:n06
- Published
- 2026.04.29
- Series
- note
- Source
- Source ↗
从相关到因果:生态学论文中如何更稳妥地写 causation?
我们经常在生态与环境论文中看到类似表述:
温度升高影响物种死亡率; 洪水改变河口双壳类丰度; 捕食者数量下降导致猎物种群增加; 人类活动改变动物栖息地利用。
这些都像是在谈“因果”。但问题是: 我们凭什么从数据中说出“导致”“影响”“改变”?
一篇 Nature Communications 的 Perspective 文章系统讨论了这个问题: Best practices for moving from correlation to causation in ecological research 。
它的核心观点很直接:
“相关不等于因果”这句话是对的,但不够。 “只有实验才能谈因果”这句话也不完全对。
设计不佳的实验可能产生错误因果结论; 设计良好的观测研究,也可能支持可信的因果推断。
关键不在于数据是不是观测数据, 而在于研究者是否清楚说明了:因果问题是什么? 已有知识支持什么? 哪些混杂因素可能存在? 哪些因果假设被采用? 方法是否与这些假设匹配?
01| 数据本身不提供因果解释
如果 X 和 Y 相关,至少有三种可能:
X 影响 Y; Y 影响 X; 第三个变量 C 同时影响 X 和 Y。
例如,瓢虫数量和蚯蚓数量可能相关。 但这不一定说明瓢虫影响蚯蚓,或蚯蚓影响瓢虫。 它们可能只是共同受到农药使用的影响。
所以,从相关走向因果,第一步不是换一个复杂模型, 而是识别并处理共同原因,也就是 confounders。
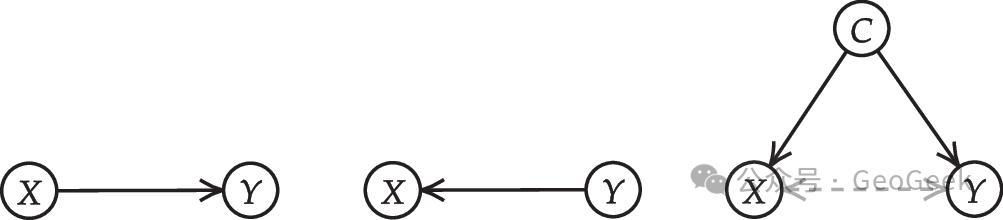
图 1|统计相关背后的三种因果可能。 可能是 X 导致 Y ,也可能是 Y 导致 X ,还可能是共同原因 C 同时影响二者。因果推断的第一步,是排除或处理由共同原因造成的混杂 (Correia et al., Nature Communications, 2026, Fig. 1) 。
02| 从相关走向因果的三个基础假设
第一, Causal Sufficiency 。 研究中需要观测并纳入所有会同时影响 X 和 Y 的共同原因。 简单说,就是没有遗漏关键混杂因素。
第二, Causal Markov Condition 。 如果 X 和 Y 的相关性完全来自共同原因 C, 那么在控制 C 之后,X 和 Y 应该变得条件独立。
第三, Causal Faithfulness 。 如果两个变量在统计上独立, 这种独立可以被解释为不存在相应因果关系的证据。
这三个假设通常无法仅靠数据完全验证。 也就是说,因果推断从来不是“让模型自己发现真相”, 而是“在明确假设下解释数据”。
03| 因果研究的 best-practice 工作流
第一步:定义因果问题,并总结已有知识。
不要一开始就问: “这个模型显著吗?”
而要先问: “我真正想回答的因果问题是什么?”
至少要明确:
结果变量 Y 是什么? 假设原因 X 是什么? 可能的混杂因素 C 有哪些? 原因是否发生在结果之前? 是否存在中介路径或反向因果?
文章建议用两类工具整理已有知识:
一类是 causal DAG ,也就是因果有向无环图; 另一类是 target trial 思想实验,即设想一个理想随机实验会如何设计。
DAG 的意义不是画一张好看的路径图, 而是把研究者的因果假设暴露出来:
哪些箭头存在? 哪些箭头不存在? 哪些变量是混杂因素? 哪些变量需要控制? 哪些变量不应该控制?
第二步:区分 causal discovery 和 causal inference。
文章强调,生态学中的因果研究至少有两类任务。
一类是 causal discovery : 当已有 知识不足 时,目标是探索变量之间是否可能存在因果关系,以及方向可能是什么。
例如: 沙丁鱼和鳀鱼种群之间是否存在因果关系? 猎物、偷猎、天气和老虎活动之间可能形成怎样的因果网络?
这类研究更偏探索。 它可以帮助生成假设,但结论通常更不确定。
另一类是 causal inference : 当已有 知识较充分 时,目标是估计因果效应的大小。
例如: 温度升高 1°C 会使野生动物死亡率增加多少? 野火抑制项目会如何改变树种组成? 洪水通过盐度和氮输入影响双壳类丰度的效应有多大?
这类研究要求更强的先验知识: 要知道哪些变量是原因,哪些是结果,哪些是混杂因素,以及因果方向大致如何。
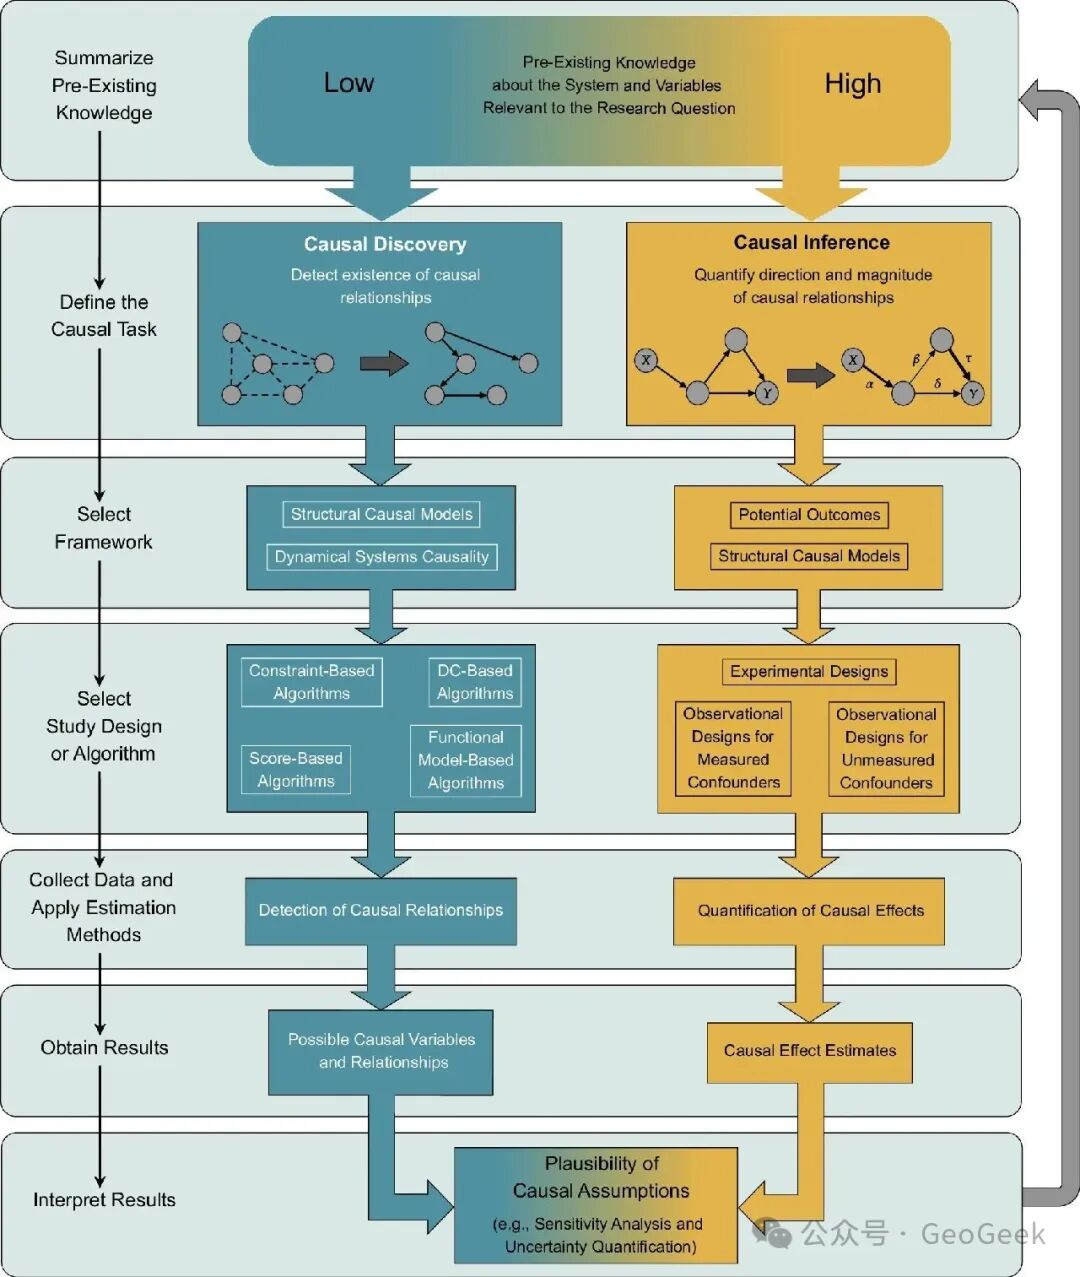
图 2|生态学因果研究的最佳实践工作流。 先定义因果问题和已有知识,再区分因果发现与因果推断,随后选择因果框架、研究设计或算法,并通过敏感性分析检验结论是否依赖关键因果假设 (Correia et al., Nature Communications, 2026, Fig. 3) 。
第三步:选择因果框架。
文章讨论了几个常见框架:
Potential Outcomes ,也叫 Neyman–Rubin 框架。 它适合把问题表述为: 如果同一个研究对象接受处理 vs 不接受处理,结果会有什么差异?
Structural Causal Model, SCM 。 它适合用因果图表达多个变量之间的结构关系。 很多结构方程模型如果要作因果解释,本质上也需要满足 SCM 中的因果假设。
Dynamical Systems Causality, DC 。 它更适合时间序列和动态生态系统。 例如判断一个变量过去的信息,是否能提高对另一个变量未来变化的预测。
第四步:选择研究设计或算法,并检验结论稳健性。
如果目标是 causal inference,文章把研究设计分为三类:
实验设计: 通过操控原因变量和随机化来减少混杂。 处理已测混杂的观测设计: 例如回归调整、倾向得分匹配、结构方程模型等。 处理未测混杂的观测设计: 当某些混杂因素无法测量时,利用外部变异或额外结构假设来识别因果效应。
如果目标是 causal discovery,文章讨论了四类算法:
constraint-based 方法; score-based 方法; functional model-based 方法; dynamical systems causality 方法,例如 convergent cross mapping。
但无论用哪类方法,文章都强调一点:
估计结果之后,不能只报告一个效应值或一张因果网络图。 还要做敏感性分析,说明如果因果假设被违反,结论会如何变化。
04| 因果研究的核心不是模型,而是假设
模型再复杂,也不能自动把相关变成因果。 机器学习、SEM、CCM、DAG、倾向得分、随机森林,都不是因果护身符。
如果没有说明:
为什么 X 的变化可以被解释为外生变化? 为什么关键混杂因素已经被处理? 为什么反向因果不构成主要问题? 为什么变量之间的时间顺序合理? 为什么未测混杂不会推翻结论?
那么“因果”两个字就写得过早。
所以,在生态学和地学论文中,因果表述可以按证据强度分层:
如果只是观测到 X 和 Y 共变, 应写“相关”“伴随变化”“统计关联”。
如果有清晰机制假设和混杂控制, 可以谨慎写“与因果解释一致”“支持 X 影响 Y 的假设”。
如果研究设计明确满足或合理替代了因果假设, 并经过敏感性分析, 才更适合写“X 对 Y 产生因果效应”。
如果存在明确反事实框架, 则可以进一步讨论“如果没有 X,Y 是否会不同”。
这也和我上一篇推文讨论的 Pearl 因果阶梯相对应:不同因果表述,其实回答的是不同层级的问题。( Seeing, Doing, What-if:论文中如何写好因果? )
写在最后
这篇文章对写论文很有启发。
它提醒我们: 从相关到因果,不是从简单模型走向复杂模型, 而是从模糊问题走向清晰问题, 从隐含假设走向显式假设, 从只报告显著性走向报告识别条件和稳健性。
好的因果论文,不只是问:“X 和 Y 是否显著相关?”
而是问: “在什么因果问题下,基于什么已有知识,采用什么不可检验但可辩护的假设,用什么设计或算法,我们才有资格把这个关系解释为因果?”
最后,强烈建议大家去读原文,非常值得一读: https://doi.org/10.1038/s41467-026-69878-z
References
Correia, H. E. et al. Best practices for moving from correlation to causation in ecological research. Nature Communications 17, 1981 (2026).